Detail Berita
BRIN Kolaborasi dengan Jepang Perkuat Infrastruktur Bank Data DNA Berstandar Internasional
Bandung - Humas BRIN. Untuk memenuhi kebutuhan DNA databank berstandar internasional, Badan Riset dan Inovasi Nasional (BRIN) tengah mengembangkan Indonesian Nucleotide Archive (INNA) yang merupakan bagian dari program RIN (Repository Ilmiah Nasional) sebagai sistem repositori untuk menyimpan data ilmiah. Budi Prawara, Kepala OREI BRIN, menyampaikan bahwa pengelolaan data genetik nasional tidak boleh sekadar menjadi tempat penyimpanan pasif.
“Infrastruktur data hayati yang terstandarisasi internasional dan disokong oleh Komputasi Berkinerja Tinggi (HPC) merupakan pilar utama kedaulatan riset masa depan Indonesia,” terang Budi dalam acara Bioinformatics Colloquium secara hibrida di Gedung ICC, KST Soekarno, Cibinong, pada Senin (18/5). Kegiatan ini digelar sebagai bagian dari upaya mematangkan cetak biru (blueprint) platform Indonesian Nucleotide Archive (INNA) menuju integrasi bank data global, otomatisasi analitis berbasis High Performance Computing (HPC), hingga implementasi kecerdasan buatan (Artificial Intelligence).
Lebih lanjut, Budi menjelaskan bahwa saat ini BRIN sedang mengembangkan platform INNA meliputi pembangunan infrastruktur repositori seperti HPC dan storage (penyimpanan), penyusunan regulasi pengelolaan repositori, serta pengembangan sumber daya manusia, termasuk kurator data DNA. “Kami juga berharap kolaborasi dengan DDBJ dan National Institute of Genetics (NIG) dapat membantu Indonesia mencapai terhadap standar global DNA databank,” harapnya.
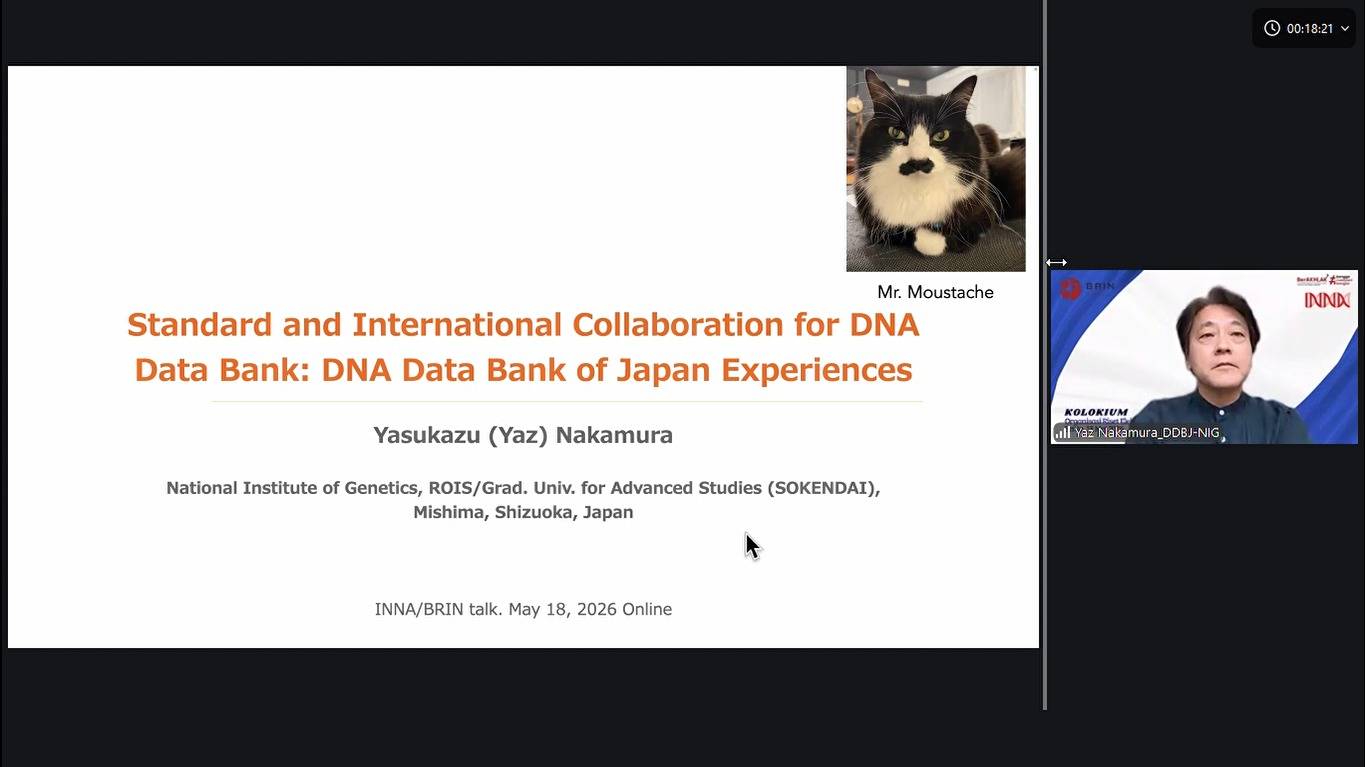
Pada kesempatan tersebut, Prof. Yasukazu Nakamura yang merupakan Head of International Affairs DNA Data Bank of Japan (DDBJ) sekaligus Profesor di NIG dan Graduate University for Advanced Studies (SOKENDAI), Jepang, memaparkan materi “Standard and International Collaboration for DNA Data Bank: DNA Data Bank of Japan Experiences”. Ia menjelaskan bahwa pada periode 2001-2007, penurunan biaya sequencing DNA masih sangat tinggi dan selaras dengan Hukum Moore.
Kemajuan teknologi sekuensing saat itu sangat bergantung pada peningkatan kecepatan komputer biasa. Sedangkan, sejak tahun 2007 hingga sekitar tahun 2020, biaya riil per megabase (Cost per Raw Megabase) dari data sekuensing DNA terjadi penurunan yang tajam. Hal ini terjadi karena adanya penemuan dan adopsi massal teknologi sekuensing generasi baru yang merevolusi industri genomik, membuat proses sekuensing DNA menjadi jauh lebih murah dan cepat, hingga kecepatannya mampu mengalahkan laju perkembangan industri komputer itu sendiri.
Untuk mengantisipasinya, DNA Data Bank of Japan (DDBJ) Jepang bekerja sama secara three party dengan National Center for Biotechnology Information (NCBI) repository milik Amerika Serikat dan European Nucleotide Archive – The European Bioinformatics Institute (ENA-EBI) repository milik Eropa di bawah konsorsium INSDC (International Nucleotide Sequence Database Collaboration) sejak tahun 1987 guna memastikan sinkronisasi data genom dunia setiap hari dengan prinsip akses bebas tanpa batasan.
“Standardisasi metadata yang ketat, seperti kewajiban mencantumkan tanggal pengumpulan dan lokasi geografis asal sampel, bukan sekadar pelengkap administratif melainkan instrumen vital untuk menjamin validitas ilmiah serta melindungi hak kekayaan intelektual peneliti melalui penerbitan accession number resmi,” tegas Prof. Yasukazu Nakamura .
Ia juga menguraikan bahwa DDBJ mengelola data mentah hasil sekuensing modern berskala besar menggunakan DDBJ Sequence Read Archive (DRA) yang diintegrasikan melalui portal terpadu D-Way. Selain itu, aspek keamanan data genotip dan fenotip manusia yang sensitif dikunci rapat melalui sistem Akses Terkontrol pada Japanese Genotype-phenotype Archive (JGA) demi mematuhi etika medis dan melindungi privasi donor/pasien.
Untuk mendukung pemrosesan data raksasa tersebut, infrastruktur komputasi DDBJ dilengkapi dengan instrumen analitis utama seperti getentry, ARSA, BLAST, hingga DFAST yang berfungsi sebagai mesin anotasi otomatis untuk meminimalkan beban input manual peneliti.
“Melalui dukungan superkomputer berskala masif, basis data genomik ini tidak lagi pasif melainkan aktif dilatih menggunakan model kecerdasan buatan untuk memprediksi struktur protein tiga dimensi dan mendiagnosis variasi genetik pemicu penyakit secara instan,” imbuhnya.
Sebagai penutup, rangkaian kegiatan kolokium diakhiri dengan sesi hands-on workshop bersama tim INNA, yaitu Rifki Sadikin, Inna Syafarina, Zahra Noviana, dan tim HPC. Melalui kegiatan ini diharapkan dapat memberikan manfaat signifikan bagi peningkatan kapasitas SDM riset nasional. Keberhasilan platform INNA kedepan akan sangat bergantung pada kemampuan Indonesia dalam memastikan tata kelola bank data hayati yang berkelanjutan, bernilai tambah ilmiah, serta mampu mendorong transfer teknologi dan penguatan ekosistem industri berbasis data di dalam negeri. (fa, kpv/ed.kg,jml)